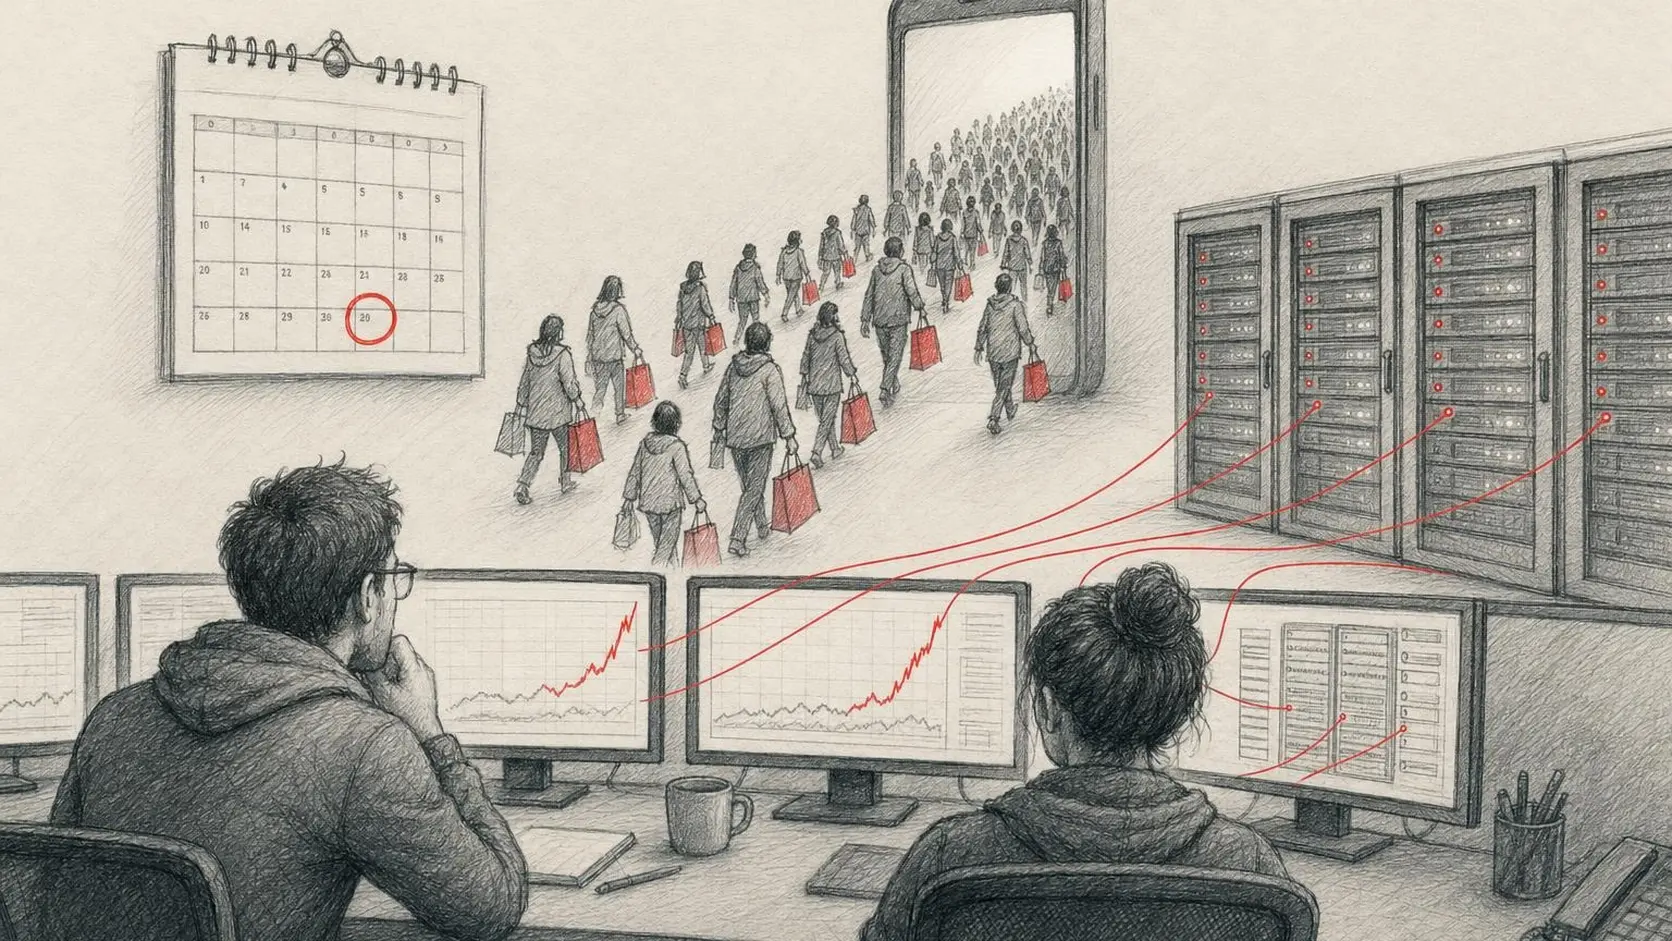
Чорна п'ятниця у 2026 році припадає на 27 листопада, Кіберпонеділок — на 30-те, а далі без пауз ідуть різдвяні й новорічні розпродажі. Для e-commerce, доставки, квиткових і фінансових застосунків це тижні, коли трафік може зрости в рази за лічені хвилини, а кожна хвилина недоступності коштує реальних грошей. Найгірше те, що проблеми в пік рідко нові: вони існували весь рік, просто навантаження їх проявило.
Нижче — практичний план підготовки мобільного клієнта і бекенду: що вимірювати, як провести навантажувальне тестування, які механізми захисту вбудувати в застосунок і як організувати чергування в день X. Якщо ви читаєте це за тиждень до піку, переходьте одразу до розділу «Якщо часу лишилося мало».
Чому мобільний застосунок ламається інакше, ніж сайт
Сайт можна виправити деплоєм за п'ять хвилин. Мобільний застосунок — ні: виправлення має пройти рев'ю, а користувачі оновлюються днями й тижнями. За даними Apple, у середньому 90% заявок розглядаються менш ніж за 24 години, але «в середньому» не означає «гарантовано в п'ятницю зранку». Тому все, що може знадобитися змінити в пік, має керуватися з сервера.
Друга особливість — клієнти самі генерують навантаження. Мільйони пристроїв, що одночасно отримали push і відкрили застосунок, або тисячі клієнтів, що агресивно повторюють запити після помилки, здатні «покласти» бекенд сильніше, ніж реальні покупці. У Google SRE Book це описано як каскадні відмови: перевантаження одного сервісу через повтори поширюється на всю систему.
Таймлайн підготовки
| Коли | Що робимо | Результат |
|---|---|---|
| За 6–8 тижнів | Прогноз піку, аудит вузьких місць, план навантажувального тестування | Цільові RPS і список ризиків |
| За 4–6 тижнів | Навантажувальні тести, оптимізація запитів, кешування, налаштування автомасштабування | Підтверджений запас потужності |
| За 3–4 тижні | Останній реліз з функціями захисту: kill switch, backoff, деградація | Застосунок, керований із сервера |
| За 2 тижні | Code freeze для мобільних релізів і змін інфраструктури | Стабільна версія у більшості користувачів |
| За 1 тиждень | Генеральна репетиція, runbook, графік чергувань, попередження провайдерів | Команда знає, що робити |
| День X | War room, моніторинг дашбордів, контрольовані push-кампанії | Швидка реакція на інциденти |
Чому останній функціональний реліз — за 3–4 тижні? Щоб версія з механізмами захисту встигла поширитися. При поетапному релізі в App Store оновлення розкочується автоматичним оновленням протягом 7 днів (1%, 2%, 5%, 10%, 20%, 50%, 100%), у Google Play staged rollout керується вручну. Плюс частина користувачів роками не вмикає автооновлення.
Крок 1. Прогноз навантаження і цільові показники
- Візьміть історичні дані. Пікова кількість запитів за секунду (RPS) минулого року, щогодинна динаміка, частка мобільного трафіку.
- Врахуйте зростання аудиторії й маркетинг. Заплановані push-кампанії, розсилки, реклама. Push на всю базу створює «стіну» трафіку протягом перших хвилин.
- Закладіть запас. Практичний орієнтир, яким користуємося ми: тестувати на 2–3× від прогнозованого піку.
- Визначте SLO на критичний шлях. Наприклад, p95 відповіді API каталогу ≤ 300 мс, частка помилок 5xx на checkout ≤ 0,5%.
Критичний шлях — це не весь застосунок. Для магазину це запуск, каталог, картка товару, кошик, оплата і статус замовлення. Рекомендації, відгуки, вішлист можуть деградувати без втрати виручки. Пам'ятайте, що за даними Baymard Institute кошики покидають близько 70% користувачів навіть у звичайні дні; повільний checkout у пік робить цю цифру гіршою.
Крок 2. Навантажувальне тестування бекенду
Інструменти на кшталт k6, Gatling чи Locust дозволяють описати сценарії поведінки, близькі до реальних. Головне — тестувати не окремі ендпоінти, а сценарії мобільного клієнта.
| Тип тесту | Що перевіряє | На що дивитися |
|---|---|---|
| Load test | Стабільність на прогнозованому піку протягом 30–60 хв | p95/p99 затримки, частка помилок, утилізація БД |
| Stress test | Точку відмови і поведінку за її межами | Чи система деградує плавно, чи падає повністю |
| Spike test | Різкий стрибок, як після масового push | Швидкість автомасштабування, холодні старти, черги з'єднань |
| Soak test | Кілька годин під навантаженням | Витоки пам'яті, переповнення пулів, ріст черг |
Типові вузькі місця, які ми знаходимо
- База даних. Запити без індексів, N+1 у списках, вичерпаний пул з'єднань. Зазвичай саме БД ламається першою.
- Стартовий запит застосунку. Один «важкий» ендпоінт конфігурації, який викликає кожен клієнт при запуску, — ідеальний кандидат для CDN і кешу.
- Сторонні сервіси. Платіжний провайдер, SMS, пошук, рекомендації мають власні ліміти. Попередьте їх про пік і з'ясуйте квоти заздалегідь.
- Автомасштабування. Нові інстанси піднімаються хвилинами, а spike триває секунди. Заздалегідь підніміть мінімальну кількість інстансів на період піку.
Крок 3. Захисні механізми в мобільному клієнті
Ці речі мають бути в застосунку до code freeze, бо додати їх у день піку неможливо.
Повтори з експоненційною затримкою і jitter
Якщо клієнт повторює запит одразу після помилки, тисячі пристроїв синхронно б'ють у сервер, що вже ледве тримається. Правильно: експоненційна затримка (1 с, 2 с, 4 с…) з випадковим зсувом і обмеженням кількості спроб. Чому jitter критичний, детально показано в статті AWS Architecture Blog. Повторюйте лише ідемпотентні запити; для створення замовлення використовуйте ключ ідемпотентності, щоб повтор не створив дубль.
Повага до 429 і Retry-After
Сервер під навантаженням має відповідати 429 Too Many Requests із заголовком Retry-After, а клієнт — чесно чекати вказаний час, показуючи зрозуміле повідомлення, а не нескінченний спінер.
Віддалена конфігурація і kill switch
Через Firebase Remote Config або власний ендпоінт конфігурації ви маєте змогу: вимкнути важкі функції (рекомендації, живий чат), збільшити інтервали оновлення, переключити застосунок у режим «тільки каталог і оплата», показати банер про технічні роботи. Перевірте, що кожен прапорець реально працює, а не лише існує в коді.
Circuit breaker і плавна деградація
Патерн circuit breaker на бекенді й у клієнті припиняє звернення до сервісу, який постійно відповідає помилками. Застосунок показує кешовані дані або спрощену версію екрана замість помилки на весь екран. Google SRE радить проектувати систему так, щоб під перевантаженням вона відкидала частину запитів контрольовано, а не падала цілком.
Крок 4. Push-кампанії без самопідриву
Push на мільйон користувачів о 00:00 — найпростіший спосіб влаштувати DDoS власному бекенду. Що допомагає:
- Розсилайте хвилями за сегментами з інтервалом 5–15 хвилин, а не всім одночасно.
- Робіть так, щоб тап по push відкривав кешований або статичний контент, а персональні дані довантажувалися пізніше.
- Враховуйте ліміти провайдера: FCM має обмеження на швидкість розсилки та на кількість повідомлень одному пристрою.
- Узгоджуйте графік push із командою інфраструктури, а не лише з маркетингом.
Крок 5. День X: моніторинг і реагування
| Метрика | Де дивитися | Сигнал для дії (приклад порогу) |
|---|---|---|
| Частка 5xx на критичному шляху | APM / логи API | > 1% протягом 5 хв |
| p95 затримки checkout | APM | > 2× від базового рівня |
| Crash-free sessions | Crashlytics / Sentry | Падіння на 0,5 п. п. від норми |
| Конверсія в оплату | Продуктова аналітика | Різке падіння при зростанні трафіку |
| Утилізація БД і пулу з'єднань | Моніторинг інфраструктури | > 80% тривалий час |
| Помилки платіжного провайдера | Логи інтеграції, статус-сторінка | Будь-яке зростання відмов |
Підготуйте runbook: для кожного сценарію (впала БД, платіжний провайдер повертає помилки, сплеск 429) — хто приймає рішення, які прапорці вмикаємо, що пишемо користувачам. Визначте чергових на кожну зміну і канал зв'язку. Рішення «вимкнути рекомендації» має прийматися за хвилину, а не обговорюватися пів години.
Типові помилки
- Реліз нової функції за день до піку. Будь-яка зміна в цей період — ризик, який не окупається.
- Тестування лише на staging із порожньою базою. Запит, що виконується 5 мс на тисячі записів, може займати секунди на десятках мільйонів.
- Агресивні повтори в клієнті. Без backoff застосунок перетворюється на джерело атаки.
- Прапорці, які ніхто не перевіряв. Kill switch, що не працює в старих версіях застосунку, марний.
- Забуті сторонні ліміти. Власний бекенд витримав, а SMS-провайдер чи геокодер почав відмовляти.
- Відсутність ретроспективи. Після піку зберіть метрики і рішення, інакше наступного року все почнеться спочатку.
Якщо часу лишилося мало: мінімальний чекліст
- Заморозьте релізи й зміни інфраструктури до завершення піку.
- Підніміть мінімальну кількість інстансів і перевірте ліміти хмарного провайдера.
- Закешуйте стартову конфігурацію, каталог і банери на CDN.
- Попередьте платіжного провайдера, SMS-сервіс і інші інтеграції про очікуваний пік.
- Перевірте, які віддалені прапорці реально працюють у версіях, що є у користувачів.
- Розбийте push-кампанії на хвилі.
- Налаштуйте алерти на 5xx, затримки, crash rate і конверсію; призначте чергових.
- Підготуйте тексти повідомлень для користувачів на випадок збою.
Джерела: Google SRE Book: Handling Overload; Google SRE Book: Addressing Cascading Failures; AWS: Exponential Backoff and Jitter; Martin Fowler: Circuit Breaker; RFC 6585: 429 Too Many Requests; App Store Connect: phased release; Google Play: staged rollouts; Apple: App Review; Firebase Remote Config; Firebase Cloud Messaging: throttling and quotas; Grafana k6; Baymard Institute: cart abandonment rate.